IAM para Agentes de IA: Arquitectura Zero Trust y Gestión de Identidades No Humanas
Descubra cómo abandonar las API keys compartidas y diseñar una capa de identidad programática basada en delegación criptográfica OBO para servidores MCP.
Descubra cómo abandonar las API keys compartidas y diseñar una capa de identidad programática basada en delegación criptográfica OBO para servidores MCP.
Los filtros de texto no detienen los ataques de indirect prompt injection. Descubre cómo la arquitectura CaMeL y el patrón Dual-LLM aplican principios clásicos de ingeniería de sistemas para separar el plano de control y el de datos, asegurando tus agentes de IA empresariales de forma definitiva.
Descubra por qué el naive chunking destruye el contexto en sistemas RAG y cómo técnicas modernas de diseño como Late Chunking y Contextual Retrieval optimizan arquitecturas empresariales equilibrando precisión técnica y finanzas FinOps.
Descubre cómo reducir la latencia P95 y los costos de inferencia en IA corporativa mediante una arquitectura multicapa. Analizamos estrategias de prefix caching a nivel proveedor y semantic caching a nivel aplicación para escalar asistentes y flujos RAG con eficiencia FinOps.
Transitar de un consumo acoplado de APIs a un plano de control unificado. Explora cómo una arquitectura AI Gateway transforma la inferencia de LLMs en un subsistema gobernable mediante enrutamiento semántico.
Descubre por qué escalar la IA exige abandonar los agentes monolíticos. Análisis de patrones de orquestación, mitigación del tool bloat y cómo el estándar A2A de la Linux Foundation transforma la arquitectura de sistemas multi agente en producción.
Descubra cómo implementar data contracts en producción empleando el estándar ODCS y estrategias shift-left para bloquear breaking changes desde el pipeline CI/CD, protegiendo así la integridad de ecosistemas analíticos y agentes de inteligencia artificial contra el schema drift.
Diseñar arquitecturas cloud en México exige cumplir con la CNBV y LFPDPPP. Descubra cómo desplegar pipelines de IA in-country en las regiones locales de AWS y Google Cloud en Querétaro para lograr latencias sub-5ms y erradicar la transferencia transfronteriza de datos financieros.
Desmitificamos el diseño de agentes de voz para producción. Conoce las claves para gestionar el presupuesto de latencia (<500ms), optimizar la economía unitaria y elegir entre pipelines en cascada por streaming y arquitecturas nativas.

La IA no eliminó el cuello de botella del SDLC, lo trasladó al Code Review. Descubre cómo la generación sin gobernanza multiplica la deuda técnica y cómo implementar Spec-Driven Development.
El diseño manual de prompts no escala en producción y se degrada ante cambios de versión. Descubre cómo DSPy separa interfaces, módulos de razonamiento y optimizadores estocásticos, transformando pipelines frágiles en sistemas deterministas y evaluables mediante CI/CD técnico.
Descubra cómo desacoplar almacenamiento y cómputo con Apache Iceberg para eliminar el vendor lock-in y unificar flujos analíticos entre AWS y Oracle Cloud Infrastructure.
Inteligencia Artificial
El «vibe check» manual no escala. Descubra cómo el Eval-Driven Development (EDD) y los Quality Gates en CI/CD protegen los despliegues de LLMs y agentes, bloqueando regresiones antes de llegar a producción mediante golden datasets y evaluaciones automatizadas.
OpenTelemetry
Un sistema de IA no falla con un HTTP 500: falla con un HTTP 200 que entrega alucinaciones. Descubra cómo OpenTelemetry GenAI Semantic Conventions unifica la observabilidad de agentes sin arquitecturas cerradas.
Lanzamiento
Construimos un asistente jurídico que cita la ley real —y que le dice a un inversionista chino qué dice la Ley Federal del Trabajo, en su idioma, sin inventarse el derecho. Preguntarle a un chatbot genérico "¿cuándo se paga el aguinaldo en México?" es una ruleta: a veces
Inteligencia Artificial
El verdadero cuello de botella de los agentes de IA corporativos no es el razonamiento del modelo, sino la fragilidad estructural de la red. Descubre cómo los motores de ejecución durable garantizan resiliencia paso a paso y protegen contra caídas en producción.
Lanzamiento
Marabunta es un prototipo: una ciudad que reporta, agentes de IA que diseñan la solución y una comunidad que la ejecuta. Todavía no opera con datos reales — pero ya se puede ver la idea completa funcionando. La Ciudad de México pierde hasta 40% de su agua potable en fugas. Una
Lanzamiento
El motor de datos detrás de Monitor Cívico, ahora como servicio: un servidor MCP que lee la Agenda de Movilizaciones de la SSC-CDMX y la vuelve consultable evento por evento. Si tu operación depende de moverte por la Ciudad de México —logística, seguridad privada, medios, operaciones de campo— la
Arquitectura de Software
Descubre cómo el Model Context Protocol resuelve la deuda técnica M x N de las integraciones de IA. Analizamos su topología, primitivas arquitectónicas y patrones de gobernanza empresarial.
Lanzamiento
Un servidor MCP legal de México: busca disposiciones, resuelve citas y definiciones, y recorre el corpus de leyes federales — con la fuente citada, no inventada. Pedirle a un modelo de lenguaje "¿qué dice el artículo tal de la Ley X?" y confiar en la respuesta es un riesgo
Launch
We built a terminal dashboard to answer that. It's called Fleet, it's open source, and it works with whatever agents you already run. If you run more than one AI coding agent at a time, you already know the failure mode. Claude Code is refactoring in
Arquitectura de Software
El RAG vectorial colapsa en la empresa cuando las consultas exigen síntesis de conocimiento transversal. Descubre cómo superar este límite multi-hop mediante una arquitectura de recuperación híbrida combinando Vector Search, GraphRAG y enrutamiento semántico.
Lanzamiento
Un servidor MCP que consulta en vivo el Padrón REPSE de la STPS y te dice tres cosas: si existe, si sigue vigente, y si su actividad autorizada cubre lo que le vas a pagar. Contratar servicios especializados en México sin verificar el REPSE es caro de una forma silenciosa:
Lanzamiento
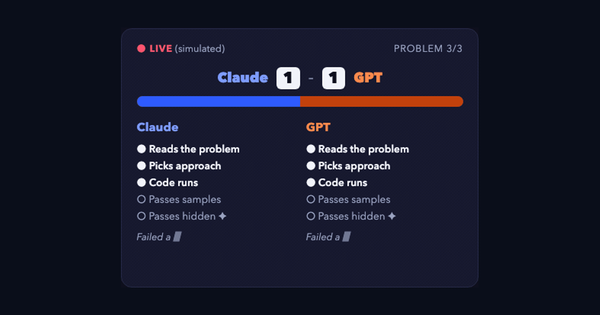
Construimos una arena para averiguarlo: dos agentes, el mismo problema, un marcador en vivo. Leer la respuesta final de un modelo es aburrido. Pero verlo trabajar —dudar, elegir un camino, corregir— podría no serlo. Quisimos probar esa hipótesis, así que construimos un piloto: League of Agents. El formato Dos agentes